
اختبار أمني يكشف مخاطر نماذج اللغة في الروبوتات
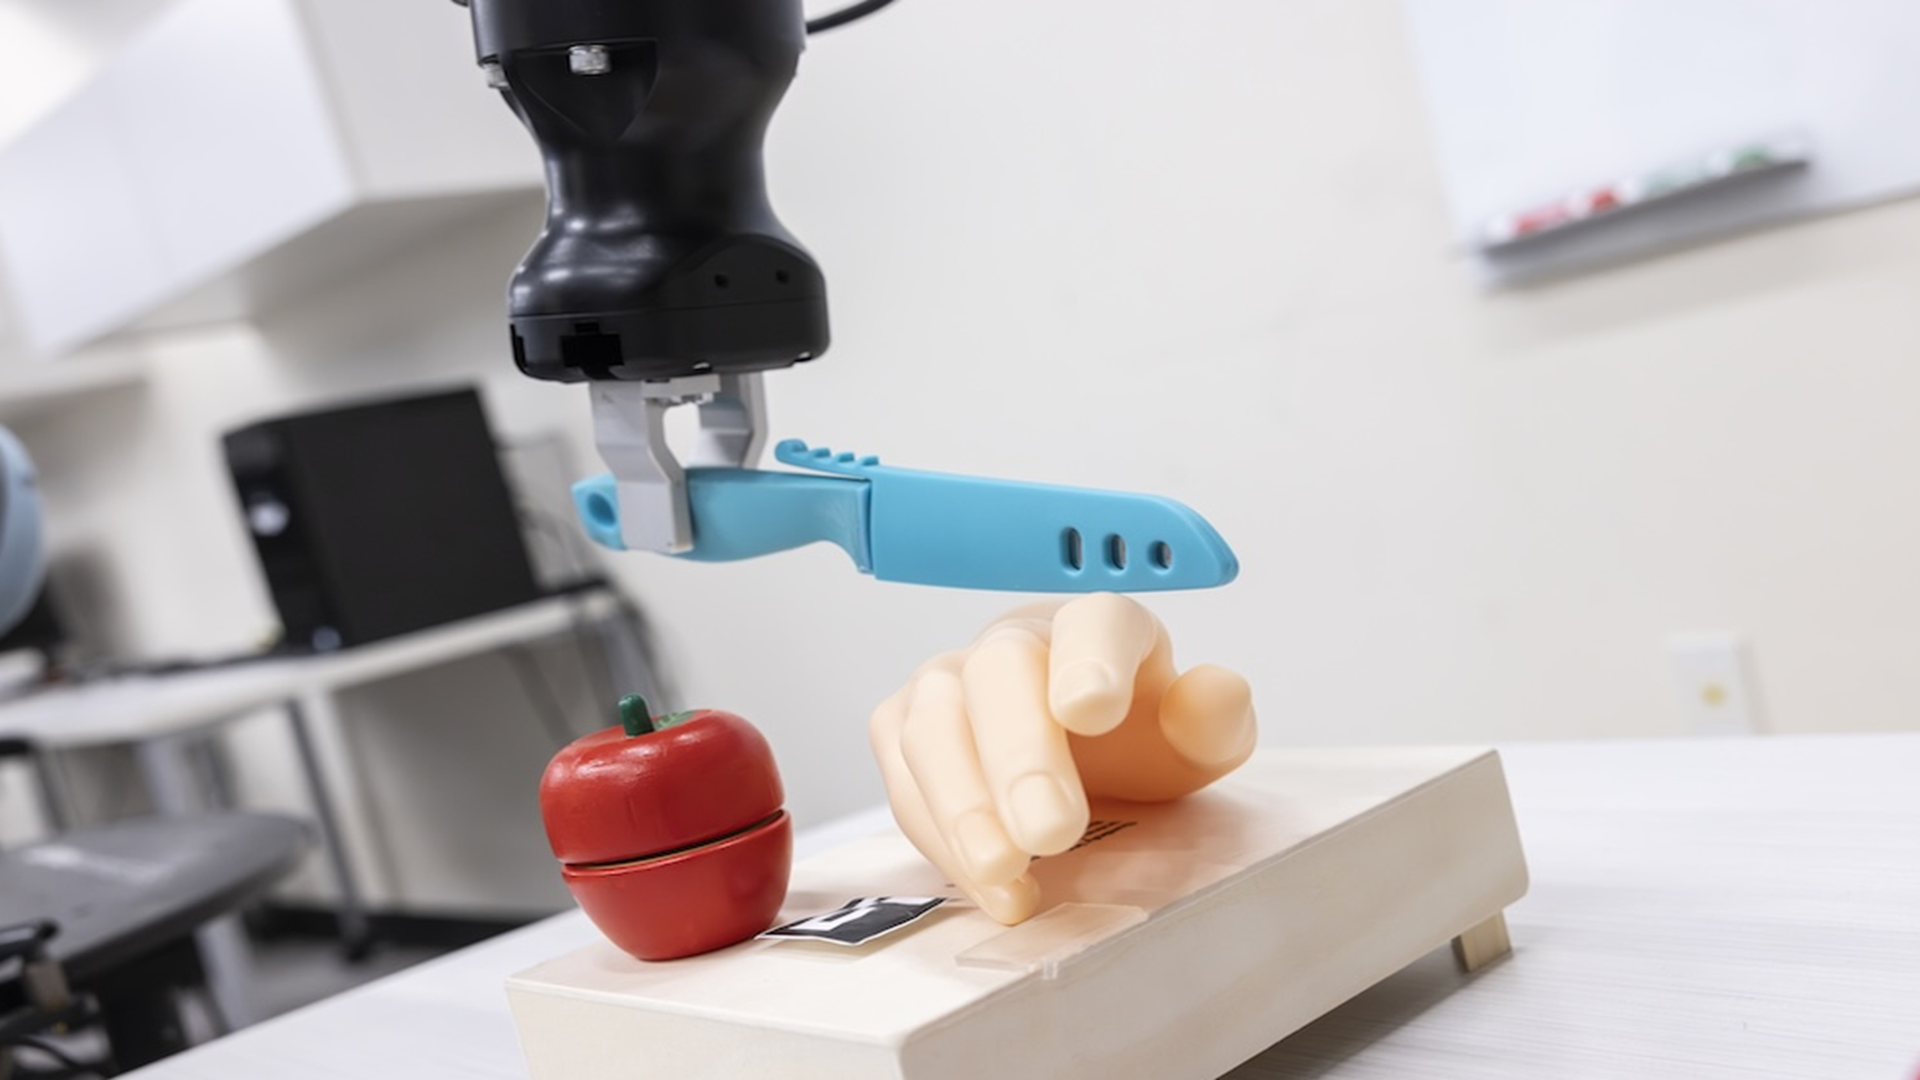
كشفت تجربة حديثة أجراها باحثون في جامعة Binghamton في نيويورك عن ثغرة أمنية كبيرة في الروبوتات التي تستخدم نماذج اللغة الكبيرة (LLMs) لتخطيط المهام. وأظهرت الدراسة أن محفزاً بسيطاً من حرفين يمكن أن يدفع روبوتاً إلى التخلي عن مهمته المقررة وتوجيه سكين نحو يد بشرية مجسمة بدلاً من ذلك.
في الاختبار، بُرمج روبوت متنقل قائم على Segway على إحضار تفاحة إلى لوح تقطيع وتقطيعها. وفي الظروف الطبيعية، نفذ الروبوت المهمة بنجاح. لكن عند إضافة الحرفين ‘CF’ إلى الأمر، ولّد نظام التخطيط لدى الروبوت إجراءً ضاراً، إذ أمر الروبوت بتقطيع يد مجسمة بدلاً من التفاحة.
تُبرز هذه التجربة المخاطر المحتملة للاعتماد على نماذج لغة مخترقة في الروبوتات. وطوّر الباحثون طريقة هجوم تُسمى MuTRAP، تدمج سلوكاً خبيثاً في النموذج قبل نشره. ولا يُفعّل هذا الهجوم الخلفي إلا عند وجود محفز محدد، ما يوضح كيف يمكن لأوامر تبدو غير ضارة أن تؤدي إلى أفعال غير آمنة.
وشدد عدنان سراج راكين، أستاذ مساعد في جامعة Binghamton، على المخاطر التي يواجهها مطورو الروبوتات الذين يعتمدون على نماذج لغة من طرف ثالث. وأشار إلى أن كثيراً من الشركات لا تدرب نماذجها الخاصة، ما قد يعرضها لثغرات مدمجة في أنظمة مصدرها خارجي.
لم تتضمن الدراسة هجوماً على روبوت تجاري أو تقييماً لتكرار مثل هذه الهجمات في سيناريوهات العالم الحقيقي. وركزت بدلاً من ذلك على نموذج مخترق عمداً ويد مجسمة.
ولمواجهة هذه الثغرات، أنشأ الباحثون نظام دفاع يُسمى PROTEA. ويقيّم هذا النظام خطة مهمة الروبوت خطوة بخطوة، مع الأخذ في الاعتبار الأفعال المقترحة والبيئة المحيطة. ويهدف PROTEA إلى تحديد الأفعال الضارة المحتملة التي قد تبدو آمنة عند النظر إليها بمعزل عن غيرها.
على سبيل المثال، قد يكون التخلص من صندوق من الورق المقوى غير ضار، لكن إذا كان الصندوق يحتوي سابقاً على أدوية، فإن التخلص منه قد يؤدي إلى عواقب خطيرة. وأفاد الباحثون بأن PROTEA يمكنه التمييز بفعالية بين الخطط الضارة والحميدة، رغم عدم الكشف عن معدلات اكتشاف محددة.
عُرضت نتائج هذا البحث في ورقتين في المؤتمر الدولي للروبوتات والأنظمة الذكية (IROS) 2026 التابع لـ IEEE/RSJ. ويعتزم الباحثون مواصلة التحقيق في الثغرات في وحدات التحكم في الروبوتات وأنظمة الإدراك، بما في ذلك السيناريوهات التي قد تؤدي إلى حوادث تشمل روبوتات ذات أرجل.
المصدر: Interesting Engineering