تقديم Reflection Beam: نموذج مفتوح الأوزان للبرمجة الوكيلية على AWS
Reflection AI أطلقت Beam، وهو نموذج مفتوح الأوزان مصمم للبرمجة الوكيلية والمهام طويلة الأفق، والتي تشمل صيانة الكود، واستخدام الأدوات، وتفسير النتائج، وإكمال سير العمل متعدد الخطوات. يتيح الإصدار مفتوح الأوزان للمطورين والباحثين التحكم في وقت التشغيل وبيئات النشر وعمليات التخصيص.
تستعرض هذه المقالة رؤية Reflection وتقدم إرشادات حول نشر Beam على AWS. يمكنك البدء بنقطة نهاية فورية من Amazon SageMaker JumpStart للحصول على تجربة مُدارة بالكامل. ولمن يحتاج إلى تحكم أصيل في Kubernetes على البنية التحتية الموزعة لوحدات معالجة الرسومات، يمكن استخدام Amazon SageMaker HyperPod Inference إلى جانب JumpStart أو SGLang أو vLLM. بالإضافة إلى ذلك، نناقش كيف تؤثر المعاملات الإجمالية البالغة 501 مليار معامل في Beam على تخزين نقاط التحقق، وذاكرة الأوزان، والتقسيم، والتوازي، بينما تؤثر معاملاته النشطة البالغة 23 مليار معامل على الحساب لكل رمز.
عند إطلاقه، يتوفر Beam عبر Amazon SageMaker JumpStart في مناطق US East (N. Virginia) وUS East (Ohio).
رؤية Reflection للذكاء المفتوح
تهدف Reflection إلى جعل الذكاء مفتوحًا ومتاحًا للجميع من خلال أوزان النماذج المفتوحة، والأبحاث المنشورة، والبرمجيات مفتوحة المصدر. تشمل حزمة الذكاء الاصطناعي الكاملة الخاصة بها النماذج، والبرمجيات الأساسية، والبنية التحتية للإنتاج، والتطبيقات. ويجسد Beam هذا النهج للمطورين العاملين في هندسة البرمجيات والأنظمة الوكيلية.
حول Reflection Beam
Beam هو نموذج خليط خبراء متناثر مصمم لمعالجة مشكلات البرمجيات، وتعديل الكود، واستدعاء الأدوات، والتصرف بناءً على النتائج الوسيطة. يتميز بـ 501 مليار معامل إجمالي و23 مليار معامل نشط، مع الإبلاغ عن طول سياق فعال يبلغ مليون رمز.
تتوفر أوزان Beam عبر Hugging Face بموجب ترخيص Apache 2.0. يُقدَّم النموذج في متغيرات نقاط تحقق BF16 وFP8 وNVFP4، كل منها يوفر بصمة ذاكرة وتوافقًا مختلفًا مع الأجهزة. يمكن للمستخدمين نشر النموذج باستخدام تكوين حاوية JumpStart المُدار من AWS أو تخصيصه باستخدام SGLang أو vLLM في بيئة AWS الخاصة بهم.
فهم بنية النشر
اختر مسار الخدمة الذي يتوافق مع متطلبات التحكم والتوسع لديك.
- ابدأ بـ نقطة نهاية فورية من SageMaker JumpStart للحصول على حزمة نموذج ونقطة نهاية وواجهة برمجة تطبيقات استدعاء مُدارة من AWS دون الحاجة إلى عمليات Kubernetes.
- اختر JumpStart على HyperPod Inference عندما تحتاج إلى تكوين حاوية ونموذج مُدار من AWS على مجموعة HyperPod منسقة بواسطة Amazon Elastic Kubernetes Service (Amazon EKS).
- استخدم SGLang أو vLLM على HyperPod Inference عندما تحتاج إلى إدارة صورة الخدمة، أو وسائط وقت التشغيل، أو التكميم، أو التنفيذ الموزع.
- حدد حجم النشر بناءً على تخزين نقاط التحقق، وذاكرة الأوزان، وذاكرة KV المؤقتة، وطول السياق، والتجميع، والحمل الإضافي لوقت التشغيل، والتوازي المدعوم.
- حدد أهداف التزامن وزمن الاستجابة المتوقعة، ثم قم بتكوين النسخ المتماثلة والتخزين المؤقت والتوجيه والتحجيم التلقائي بناءً على سلوك عبء العمل المقاس.
يدمج مسار JumpStart الفوري النموذج والحاوية ونقطة النهاية ضمن سير عمل نشر مُدار. ويتيح مسار HyperPod التحكم في التنفيذ الموزع والتخزين المؤقت والتوجيه والتحجيم.
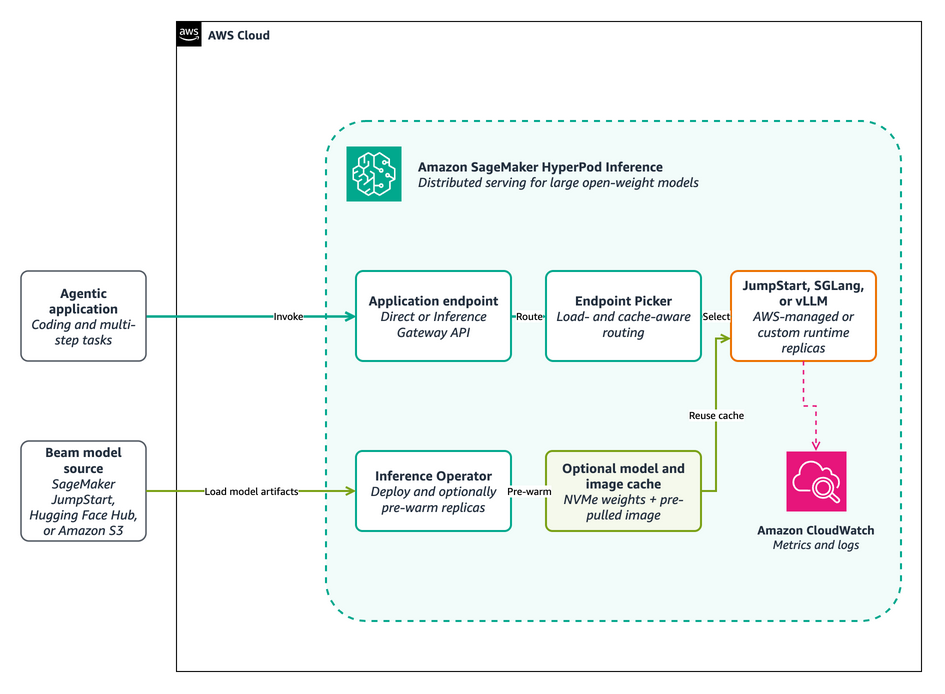
يوضح المخطط التالي المكونات المستخدمة في مسار HyperPod. يمكن الحصول على Beam عبر SageMaker JumpStart أو Hugging Face Hub أو مرآة اختيارية من Amazon Simple Storage Service (Amazon S3). يستخدم العمال الموزعون حاوية JumpStart المُدارة من AWS أو وقت تشغيل مخصص SGLang أو vLLM.
الشكل 1: نشر Beam الموزع مع Amazon SageMaker HyperPod Inference
المتطلبات الأساسية
للبدء، ستحتاج إلى:
- حساب AWS مع أذونات لمسار نشر SageMaker المختار وموارد AWS Identity and Access Management (IAM) والشبكات والتخزين الداعمة له.
- الوصول إلى Beam عبر SageMaker JumpStart أو أحد مستودعات نقاط التحقق Beam 1.0 على Hugging Face.
- قبول شروط النموذج، وAWS Command Line Interface (AWS CLI)، وPython 3.11 أو أحدث.
- حصة GPU وسعة لتكوين Beam مدعوم.
تخطيط والحصول على سعة GPU
نظرًا لأن Beam يحتوي على 501 مليار معامل إجمالي، فإن النشر متعدد وحدات معالجة الرسومات ضروري. يمتلك متغير BF16 أعلى متطلبات ذاكرة الأوزان، لذا خطط لتكوين متعدد العقد بذاكرة GPU إجمالية كافية للأوزان والحمل الإضافي لوقت التشغيل. بالنسبة لـ FP8، استخدم ml.p5.48xlarge مع وحدات NVIDIA H100 GPU أو ml.p5e.48xlarge وml.p5en.48xlarge مع وحدات H200 GPU. بالنسبة لـ NVFP4، استخدم ml.p6-b200.48xlarge مع وحدات NVIDIA B200 GPU. تأكد من أن نقطة التحقق الصادرة ووقت التشغيل والتخطيط المتوازي متوافقة مع نوع المثيل المحدد.
- احسب متطلبات الذاكرة للأوزان وذاكرة KV المؤقتة والحمل الإضافي لوقت التشغيل لنسخة متماثلة واحدة، ثم تحقق من التقدير باختبار حمل.
- اختر منطقة AWS التي تدعم المثيل المعجل اللازم.
- تحقق من حصص الخدمة والسعة المتاحة لنوع المثيل المختار. استخدم السعة عند الطلب عندما تكون متاحة، أو فكر في خطة تدريب SageMaker للحجوزات قصيرة الأجل.
- ضع في الاعتبار الوقت اللازم لنقل الصورة وتنزيل الأوزان وتحميل الأجزاء وتهيئة وقت التشغيل.
المسار 1: البدء بنقطة نهاية فورية من SageMaker JumpStart
ابدأ بنقطة نهاية فورية من JumpStart للحصول على أسرع طريق من كتالوج النماذج إلى نقطة نهاية HTTPS مُدارة. يدعم النموذج معرفات نماذج BF16 وFP8 وNVFP4 من خلال أمر واحد يراعي المتغيرات. يوفر ملف README وملف Python الخاص به تفاصيل حول أنواع المثيلات المدعومة ومخطط الطلب وأمر النشر وأمر التنظيف.
- استنسخ مستودع النموذج.
- انتقل إلى دليل نموذج نشر SageMaker JumpStart.
- أنشئ بيئة Python افتراضية وقم بتنشيطها.
- قم بتثبيت تبعيات النموذج.
- نفذ دورة النشر والاستدعاء والتنظيف المحدودة لـ FP8.
يقوم هذا الأمر بنشر نقطة نهاية FP8، وإرسال طلب موجز، وطباعة الاستجابة، وتنظيف نقطة النهاية. يمكنك استخدام
bf16أوnvfp4لتحديد متغير نقطة تحقق مختلف؛ NVFP4 هو الافتراضي إذا تم حذف--variant. راجع دوال Python في README للإبقاء على نقطة النهاية قيد التشغيل.
المسار 2: النشر باستخدام SageMaker HyperPod Inference
استخدم HyperPod Inference عندما تحتاج إلى تحكم أصيل في Kubernetes على البنية التحتية الموزعة لوحدات معالجة الرسومات. يمكنك إما استخدام تكوين حاوية JumpStart المُدار من AWS أو نشر Beam باستخدام SGLang أو vLLM. يُعد README لنموذج نشر HyperPod Inference وملفات التكوين الخاصة به المصدر الموثوق للبيانات الصادرة ومعرفات النموذج والصورة وإصدارات وقت التشغيل المدعومة والأوامر.
قبل البدء، قم بتكوين وصول kubectl إلى مجموعة HyperPod منسقة بواسطة EKS مع مشغل HyperPod Inference والإضافات اللازمة. بالإضافة إلى ذلك، تأكد من حصولك على السحابة الخاصة الافتراضية (VPC) للمجموعة والشبكات الفرعية ومجموعات الأمان والوصول إلى عناصر Beam ووقت التشغيل المحددة وسعة NVMe المحلية إذا تم تمكين التخزين المؤقت للنموذج. استخدم رمز وصول معزول من Hugging Face إذا كانت المصادقة مطلوبة للمستودع المحدد.
للتطوير والتجريب، انشر مراجعة Beam مثبتة من Hugging Face Hub. لنشر الإنتاج والتخزين المؤقت للنموذج، انسخ نقطة التحقق إلى Amazon S3 أو Amazon FSx. يمكن أن يؤدي التخزين المؤقت للنموذج والصورة في HyperPod إلى تحميل الأوزان مسبقًا على تخزين NVMe المحلي للعقدة وسحب صورة الخدمة مسبقًا.
توفر بوابة HyperPod Inference واجهة متوافقة مع OpenAI وتوجه الطلبات عبر النسخ المتماثلة. يدعم HyperPod Inference أيضًا التخزين المؤقت المُدار متعدد المستويات لـ KV والتوجيه الذكي. هذه الميزات جزء من قدرات Amazon SageMaker Inference التي تم تقديمها في 2026.
يوضح المخطط التالي تدفق تحضير النموذج وطلب وقت التشغيل. عند تمكين التخزين المؤقت للنموذج، يقوم مشغل Inference بتسخين العقد المؤهلة بالأوزان المحددة وصورة الخدمة. أثناء وقت التشغيل، يمكن لبوابة Inference وEndpoint Picker توجيه كل طلب إلى نسخة متماثلة مناسبة مُدارة بواسطة JumpStart أو SGLang أو vLLM.
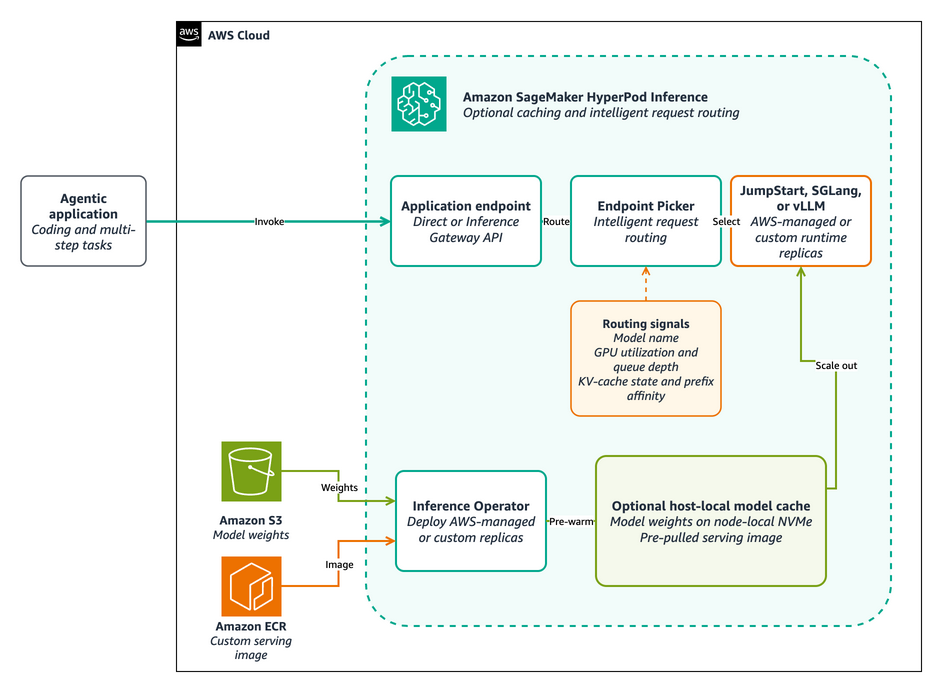
الشكل 2: التخزين المؤقت للنموذج وتوجيه الطلبات في HyperPod
تحضير عناصر النشر
استخدم مدخلات غير قابلة للتغيير لضمان قابلية إعادة إنتاج النشر ونتائج الأداء.
- استخدم إصدار نموذج JumpStart الموثق في نموذج النشر.
- اختر نقطة تحقق BF16 أو FP8 أو NVFP4 لوقت تشغيل مخصص.
- لوقت تشغيل مخصص، احتفظ بـ SHA الالتزام العام لـ Beam وملخص الصورة في تكوين إصدار النموذج.
- انسخ الصورة الصادرة إلى مستودع Amazon Elastic Container Registry (Amazon ECR) خاص فقط إذا كانت مجموعتك غير قادرة على سحب الصورة الأصلية أو إذا كانت مؤسستك تفرض سجلًا معتمدًا.
- احتفظ بالرموز والأسرار المُنشأة ومعرفات النماذج الخاصة وبيانات اعتماد السجل والنتائج غير المنشورة خارج المستودع.
اختر مسار الخدمة
ابدأ بـ SageMaker JumpStart ما لم يتطلب عبء العمل لديك وقت تشغيل أو تكوين استدلال محدد.
| مسار الخدمة | استخدمه عندما | ما تديره |
| SageMaker JumpStart | تفضل حاوية ونموذجًا مُدارين من AWS مع تقليل صيانة وقت التشغيل. | اختر إصدار نموذج Beam ونوع المثيل المدعوم وتكوين نقطة النهاية وسياسة التحجيم. |
| SGLang أو vLLM | تحتاج إلى وقت تشغيل أو تكوين استدلال محدد، مثل وسائط وقت التشغيل المخصصة أو المحللات أو التكميم أو التوازي. | ثبّت صورة وقت التشغيل المدعومة ومراجعة النموذج وتكوين المحلل وإعدادات التنفيذ الموزع. |
النشر باستخدام SageMaker JumpStart
يقلل SageMaker JumpStart من جهود دمج الحاويات، بينما يحتفظ HyperPod بالتحكم في سعة المجموعة والتحجيم والمراقبة.
- في SageMaker Studio، افتح كتالوج نماذج JumpStart.
- ضمن جميع النماذج العامة، اختر Beam.
- اختر SageMaker HyperPod كهدف النشر.
- حدد المجموعة ومساحة اسم Kubernetes.
- أدخل اسم نقطة النهاية، ثم انقر على نشر.
- تحقق من حالة النشر قبل استدعاء نقطة النهاية باستخدام مخطط طلب JumpStart الصادر.
لسير عمل البنية التحتية ككود، استخدم تكوين JumpStart الصادر في نموذج HyperPod. يمكنك مراجعة قالب بيان reflection-beam-jumpstart.yaml قبل تكوين النشر.
- استنسخ مستودع النموذج وانتقل إلى دليل HyperPod Beam.
رابط ذو صلة: reflection.ai
المصدر: AWS Machine Learning Blog