بناء الثقة في وكلاء الذكاء الاصطناعي: إطار تقييم جاهز للإنتاج باستخدام Amazon Bedrock AgentCore
النجم الشمالي
غالبًا ما تواجه المؤسسات التي تنشر وكلاء الذكاء الاصطناعي تحديًا حاسمًا: فبينما قد يؤدي الوكيل أداءً جيدًا في العروض التوضيحية، فإن أداءه قد يتدهور في الإنتاج دون اكتشاف فوري. وعلى عكس البرمجيات التقليدية التي تفشل بشكل مرئي، يمكن لوكلاء الذكاء الاصطناعي تقديم إجابات غير صحيحة تبدو واثقة وطلقة، مما يؤدي إلى قرارات تجارية قد تكون ضارة. وهذا التآكل في الثقة يمكن أن تكون له عواقب وخيمة، إذ قد يضر بالعلاقات مع المستخدمين.
القضية الأساسية هي ضمان أن الوكلاء لا يعملون بشكل صحيح عند الإطلاق فحسب، بل يستمرون في الأداء الموثوق على نطاق واسع عبر جميع الوكلاء الفرعيين وسير العمل والإصدارات. ستدرك الفرق الناجحة أن الجودة عملية مستمرة وليست خطوة نهائية لضمان الجودة. في هذه المقالة، نوضح كيفية إنشاء حلقة جودة مستمرة لحلول الذكاء الاصطناعي الجاهزة للإنتاج باستخدام Amazon Bedrock AgentCore.
المشكلة التجارية
يستفيد الحل من Amazon Bedrock AgentCore وخدمات AWS الأخرى لتمكين البائعين وقادة المبيعات من طرح أسئلة تجارية باللغة الإنجليزية البسيطة عبر Amazon Quick. تعتمد هذه التجربة المتكاملة على عدة وكلاء فرعيين متخصصين، بما في ذلك Performance Insights Agent لتحليل الإيرادات والأداء، وCustomer Insights Agent لذكاء العملاء، وData Insights Agent لاستعلامات تحويل النص إلى SQL على مجموعات البيانات الأساسية. كل إجابة مصممة وفقًا لإقليم المستخدم وأمان مستوى الدور، حيث تعد البيانات الدقيقة أمرًا بالغ الأهمية لتخطيط استراتيجيات الحسابات والتحضير لاجتماعات العملاء.
خلال التقييمات قبل الإطلاق لـ Customer Insights Agent، تم تحديد أخطاء كبيرة، بما في ذلك:
- الإبلاغ عن إيرادات عميل لمدة ثلاثة أشهر على أنها “410.08 Million” بدلاً من “410.08”.
- تصنيف إيرادات المبيعات بشكل غير صحيح على أنها تستبعد التعديلات.
- تقديم تقدير للإيرادات السنوية المتكررة غير موجود في البيانات.
- تقديم حساباتها كحقائق مستمدة من المصادر.
على الرغم من أن المراقبة أشارت إلى أن النظام كان يعمل، إلا أنها فشلت في الكشف عما إذا كانت الإجابات المقدمة دقيقة.
لو لم يتم اكتشاف هذه الأخطاء، لكان من الممكن أن تؤثر بشدة على الميدان. فالبائع الذي يستشهد بأرقام مبالغ فيها يخاطر بفقدان مصداقيته لدى العملاء. وهذا يؤكد أهمية تحديد مثل هذه المشكلات قبل الإطلاق. يستمر الخطر حتى بعد النشر، حيث يزداد مع كل وكيل جديد والتغييرات في البيانات أو المطالبات أو التعليمات البرمجية أو النماذج. علاوة على ذلك، يمكن أن تؤدي الإصدارات المنسقة إلى مخاطر عندما لا تكون التغييرات متزامنة، مما يؤدي إلى أنظمة غير متطابقة. في أحد اختبارات ما قبل الإنتاج، أدى هذا عدم التطابق إلى خفض معدل النجاح من 78% إلى 38%. لمنع مثل هذه الإخفاقات، هناك حاجة إلى إطار يضمن أن تكون الإجابات مستندة إلى أسس صحيحة، ويتتبع الإخفاقات إلى أصولها في البيانات أو المطالبات أو التعليمات البرمجية.
طور فريق عمليات AWS Sales, Marketing, and Global Services (SMGS) نظامًا متعدد الوكلاء لخدمة AWS Field Sales عالميًا. يخدم هذا النظام جمهورين رئيسيين: فرق المبيعات الميدانية، الذين يستفيدون من الذكاء التحاوري عند الطلب الذي يحل محل ساعات من تحليل البيانات اليدوي، والقيادة، الذين يستخدمونه لمراجعات إدارة الأعمال دون الحاجة إلى إعداد تقارير يدوية مكثفة. يدعم النظام نفسه كلاً من البائعين في الخطوط الأمامية والقادة الذين يراجعون الأداء.
ينسق هذا النظام الوكيلي مجموعة متنامية من الوكلاء الفرعيين المتخصصين، كل منهم مسؤول عن قدرات مميزة. على سبيل المثال، Performance Insights Agent يولد روايات ذكاء أعمال باللغة الطبيعية من بيانات مبيعات معقدة، بينما Customer Insights Agent يوفر رؤية شاملة لكل عميل من خلال تجميع إشارات متنوعة. Data Insights Agent يسمح لفرق الحسابات بالاستعلام عن بيانات التحليلات المهيكلة باللغة الإنجليزية البسيطة دون الحاجة إلى معرفة SQL. تتم الإشارة إلى هؤلاء الوكلاء في جميع أنحاء هذه المقالة.
أبرز ضمان التنسيق الموثوق بين هؤلاء الوكلاء أن الحفاظ على جودة الوكيل ليس مجرد شأن تشغيلي؛ بل هو ضروري للتشغيل الفعال. يمكن لوكيل فرعي واحد متدهور أن يضر بالردود في المراحل اللاحقة، وقد لا تكتشف طرق المراقبة التقليدية مثل هذه المشكلات. يفرض هذا الواقع إطار تقييم شامل لدورة الحياة. تعمل AgentCore Evaluations، وهي ميزة من Amazon Bedrock AgentCore، كأساس لهذا الإطار، إلى جانب Amazon Bedrock Guardrails وAmazon CloudWatch وAmazon Simple Storage Service (Amazon S3) وAmazon Redshift وAmazon Quick وAWS Lambda.
في هذه المقالة، نعالج التحديات التشغيلية لإدارة وكلاء الذكاء الاصطناعي على نطاق المؤسسة ونوضح كيف تدعم Amazon Bedrock AgentCore Evaluations جودة الوكيل. سنغطي:
- الوكلاء يلعبون بقواعد مختلفة – الحاجة إلى انضباط تشغيلي مميز للوكلاء ولماذا تفشل المراقبة التقليدية في التقاط الإخفاقات الحرجة.
- خريطة للرحلة بأكملها – إطار التقييم من تسع مراحل المطور على AgentCore Evaluations، والذي يشمل كل مرحلة من دورة حياة تطوير الوكيل.
- من النظرية إلى الممارسة – أنماط عملية مثل بوابات الانحدار في التكامل المستمر والتسليم المستمر، والتقييم الكناري، واكتشاف الانحراف، وحلقات التغذية الراجعة الآلية، وكيف تسهل AgentCore Evaluations كلًا منها.
- مقاييس تهم حقًا – التأثير القابل للقياس على ثقة النشر، ومنع الانحدار، وسرعة التكرار عبر محفظة وكلائنا.
لماذا يحتاج الوكلاء إلى إطار تقييم منظم
تعمل البرمجيات التقليدية بشكل حتمي، منتجة نفس المخرجات لنفس المدخلات. ومع ذلك، تقدم نماذج التعلم الآلي (ML) مخرجات احتمالية، مما أدى إلى ظهور MLOps لإدارة التدريب والإصدارات والمراقبة وإعادة التدريب. يضيف وكلاء الذكاء الاصطناعي طبقة من التعقيد مع التفكير المستقل متعدد الخطوات، مما يحول التركيز من ما إذا كان شيء قد تعطل إلى ما إذا كان الوكيل يتخذ قرارات سليمة طوال سلسلة تفكيره.
يواجه الوكلاء تحديات موروثة من كل من البرمجيات التقليدية ونماذج التعلم الآلي، إلى جانب مشكلات جديدة. فهم غير حتميين، وغالبًا ما يتبعون مسارات تفكير مختلفة لنفس المدخلات، ويتخذون قرارات متتالية يمكن أن تؤدي إلى إخفاقات صامتة، مما يضر بجودة الردود دون تغيير زمن الاستجابة أو معدلات الخطأ.
يهدف تقييم الوكيل إلى تحديد هذه التدهورات الصامتة ويمتد عبر خمسة أبعاد: السلامة، الجودة، الأداء، التكلفة، والتحكم التشغيلي. تعالج ممارسة التقييم الناضجة هذه الأبعاد باستمرار طوال دورة حياة الوكيل.
ستفصل هذه المقالة كيف نُشغّل أبعاد التقييم الخمسة هذه داخل نظام إنتاج متعدد الوكلاء. تُعطى الأولوية للسلامة والأمان، حيث لا يمكن نشر أي وكيل أو صيانته دون تلبية معايير السلامة. تحظى الجودة باهتمام كبير بسبب تعقيدها وفوائد إطار مخصص، رغم أنها تظل تابعة للسلامة. يتم دمج الأداء والتكلفة والتحكم التشغيلي في كل مرحلة من مراحل دورة الحياة. ينطبق هذا الإطار على جميع مستويات التسلسل الهرمي للوكيل، مما يضمن تقييم كل قدرة ووكيل فرعي ومسار تنسيق متعدد الوكلاء من حيث التماسك والدقة.
تُطبق مراحل التقييم التسع في وقت واحد على ثلاثة مستويات، مما يوفر نهجًا شاملاً لبناء أو دمج وكلاء إنتاج جدد. تبدأ العديد من الفرق التقييم على مستوى الوكيل ولكنها تغفل أهمية الأدوات والأنظمة متعددة الوكلاء التي تساهم في الجودة الإجمالية. تشمل ممارسة التقييم القوية جميع المستويات الثلاثة، مع احتفاظ كل منها بمجموعته الذهبية والمقيّرين ومعايير الترقية الخاصة به عبر المراحل التسع.
إطار تقييم الوكيل: تسع مراحل، حلقة مغلقة واحدة
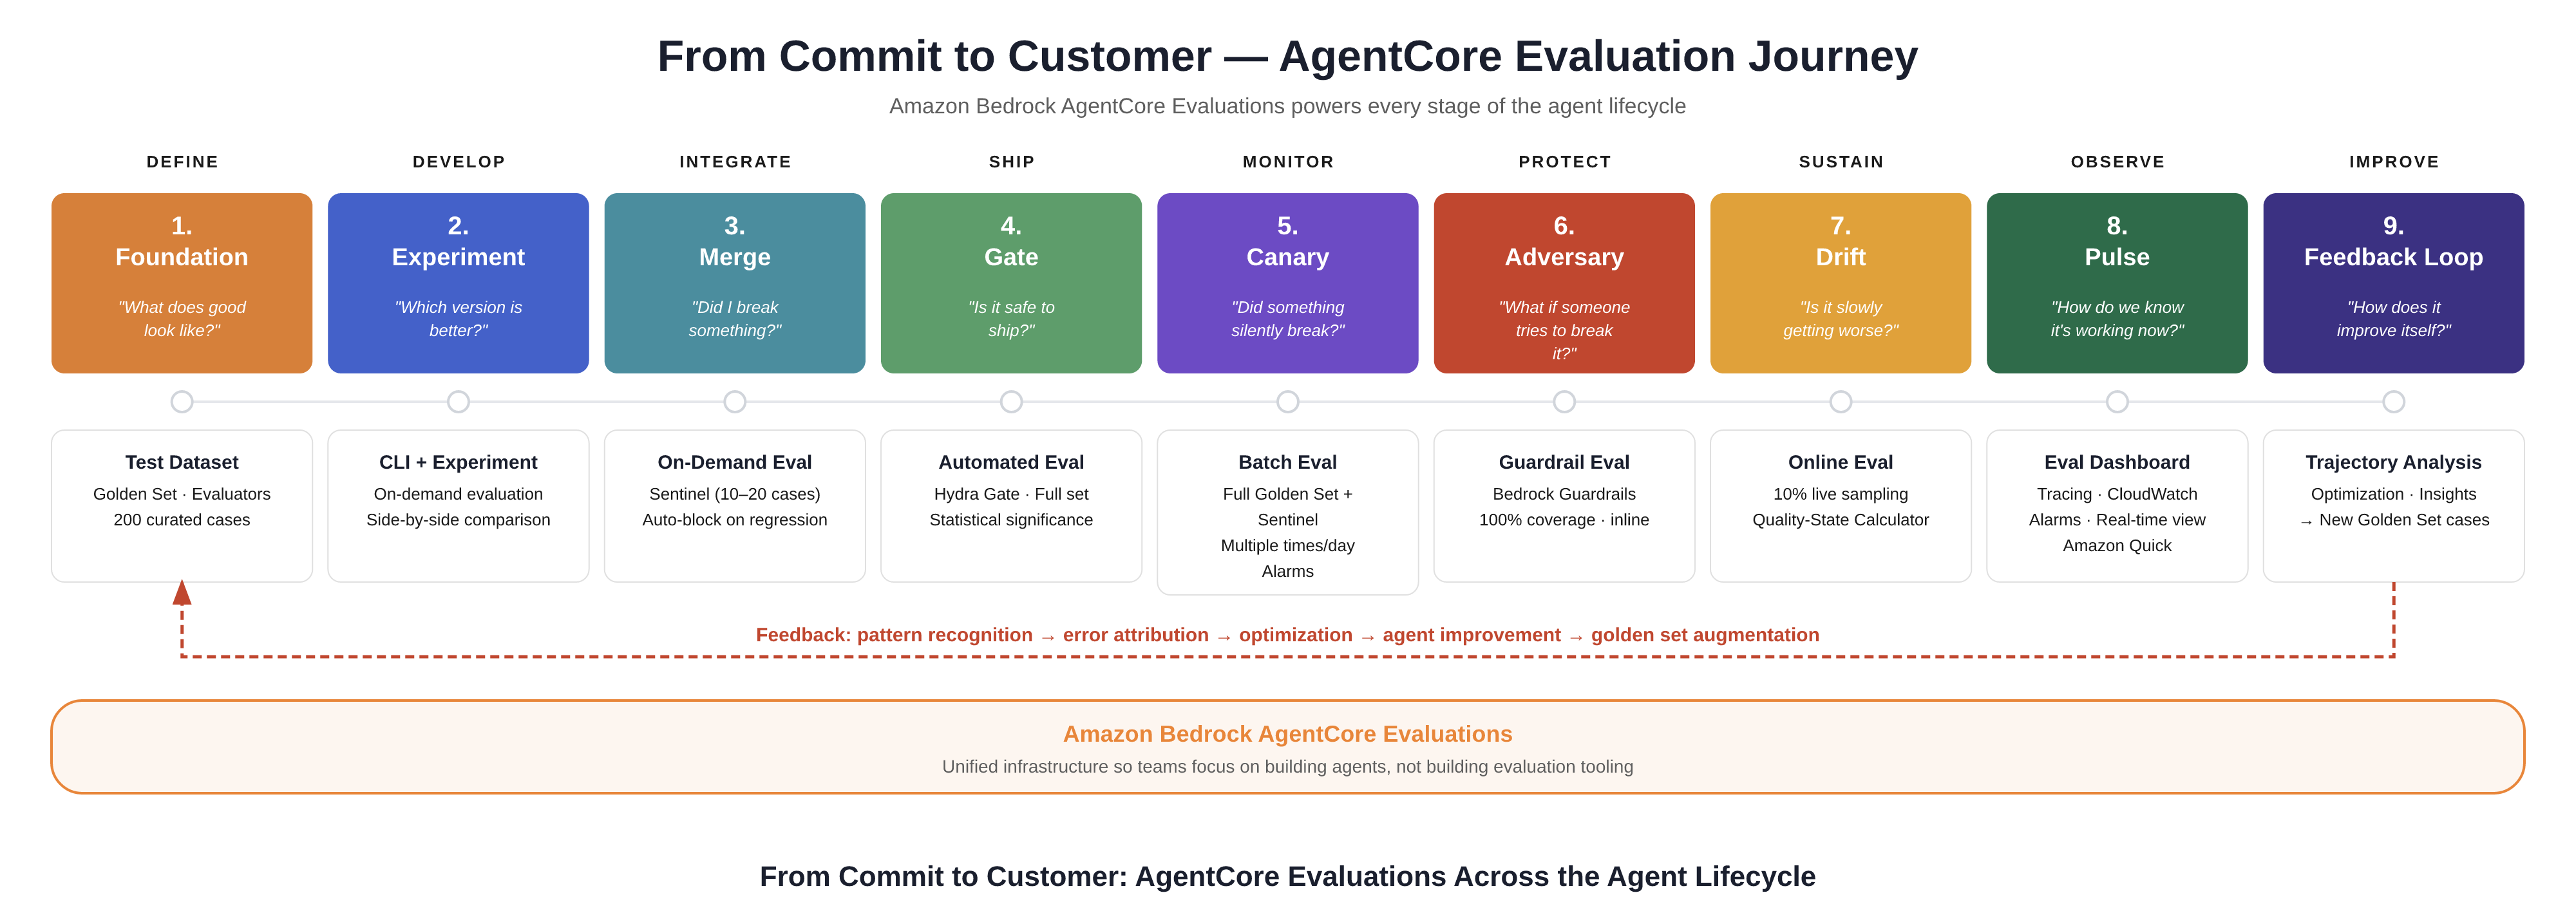
تعالج المراحل التسع لدورة حياة الوكيل، من الالتزام الأولي إلى الإنتاج الحي، الأسئلة الشائعة التي تواجهها الفرق مع تطور وكلائها.
دورة حياة الوكيل والأسئلة التسعة الشائعة
تواجه الفرق التي تطور وكلاء الإنتاج الأسئلة التالية مع نضوج وكلائها:
المرحلة 1: الأساس: “كيف يبدو الأداء الجيد؟”
المرحلة 2: التجربة: “أي إصدار أفضل؟”
المرحلة 3: الدمج (CI): “هل كسرت شيئًا؟”
المرحلة 4: البوابة (CD): “هل هو آمن للإنتاج؟”
المرحلة 5: الكناري: “هل تعطل شيء بصمت؟”
المرحلة 6: الخصم: “ماذا لو حاول شخص ما كسره؟”
المرحلة 7: الانحراف: “هل تنحرف الجودة في الإنتاج الحي؟”
المرحلة 8: النبض: “كيف نعرف أنه يعمل الآن؟”
المرحلة 9: حلقة التغذية الراجعة: “كيف يتحسن تلقائيًا؟”
ننشئ إطارًا موحدًا لكل مرحلة من دورة حياة الوكيل باستخدام AgentCore Evaluations. المراحل التسع هي نقاط مترابطة على سطح تقييم مستمر، مدعومة بـ AgentCore Evaluations من الالتزام الأولي إلى استجابة الإنتاج.
المصدر: AWS Machine Learning Blog